Machine Learning & Analytics
Data Mining
A 3-part data mining curriculum covering Census Income classification, MovieLens association rule mining (Apriori), and customer segmentation with K-Means clustering.
Project Overview
Completed as part of NTU's Data Mining module (IN6227), this project consolidates three core machine learning assignments: (1) automated preprocessing and classification on the Adult Census Income dataset, (2) association rule mining comparing Apriori and brute-force approaches on MovieLens, and (3) unsupervised customer segmentation using K-Means clustering with Elbow/Silhouette validation and geometry analysis.
Key Architecture & Contributions
- Assignment 1: Built an automated ColumnTransformer preprocessing pipeline and optimized Random Forest & Logistic Regression models via GridSearchCV.
- Assignment 2: Benchmarked Apriori vs brute-force frequent itemset discovery across varying basket dimensions on MovieLens.
- Assignment 3: Developed custom K-Means centroid convergence visualizers, determined optimal clusters with WCSS/Silhouette, and evaluated cluster shape limitations.
Coursework Breakdown
The 3 Data Mining Assignments
Assignment 1: Data Preprocessing & Predictive Modeling
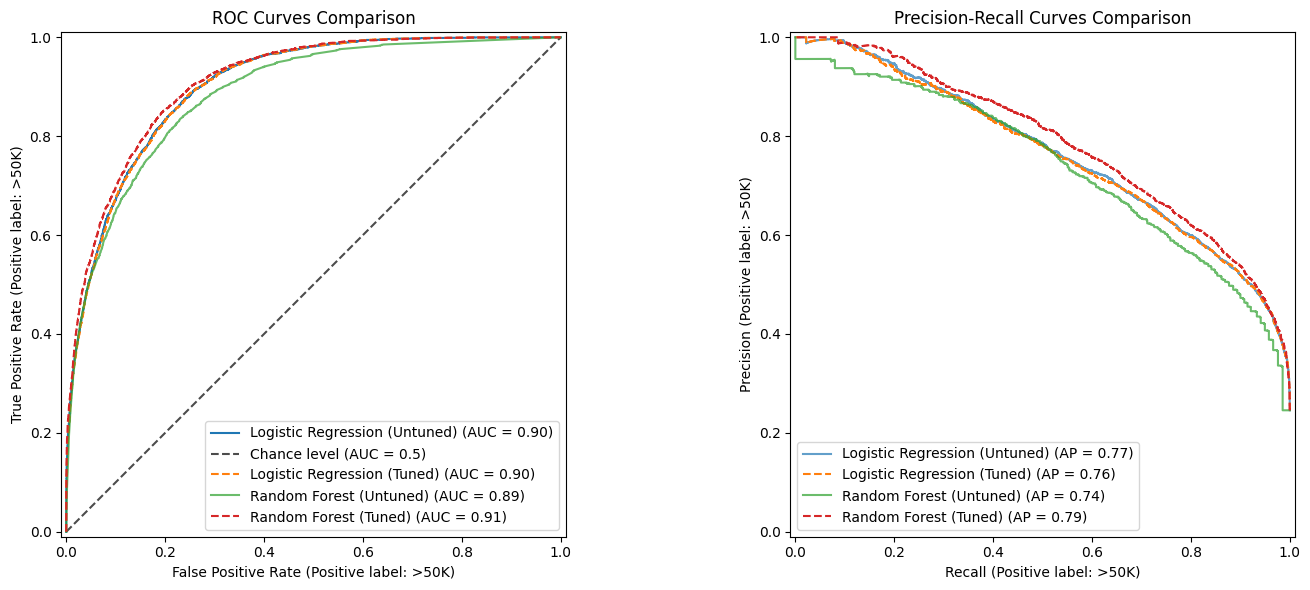
End-to-end data cleaning, handling missing values, categorical encoding, and feature scaling using Scikit-Learn pipelines. Benchmarked Logistic Regression and Random Forest with GridSearchCV hyperparameter tuning.
Model Evaluation: ROC & Precision-Recall Curves (Logistic Regression vs Random Forest)
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV

# Automated preprocessing pipeline
preprocessor = ColumnTransformer([
    ('cat', OneHotEncoder(handle_unknown='ignore'), categorical_cols),
    ('num', StandardScaler(), numerical_cols)
])

pipe_rf = Pipeline([
    ('preprocessor', preprocessor),
    ('clf', RandomForestClassifier(random_state=42))
])

# Hyperparameter optimization using GridSearchCV
param_grid = {
    'clf__n_estimators': [50, 100],
    'clf__max_depth': [10, 20]
}
grid_search = GridSearchCV(pipe_rf, param_grid, cv=3, scoring='f1_macro')
grid_search.fit(X_train, y_train)Assignment 2: Association Rule Mining (Apriori vs Brute Force)
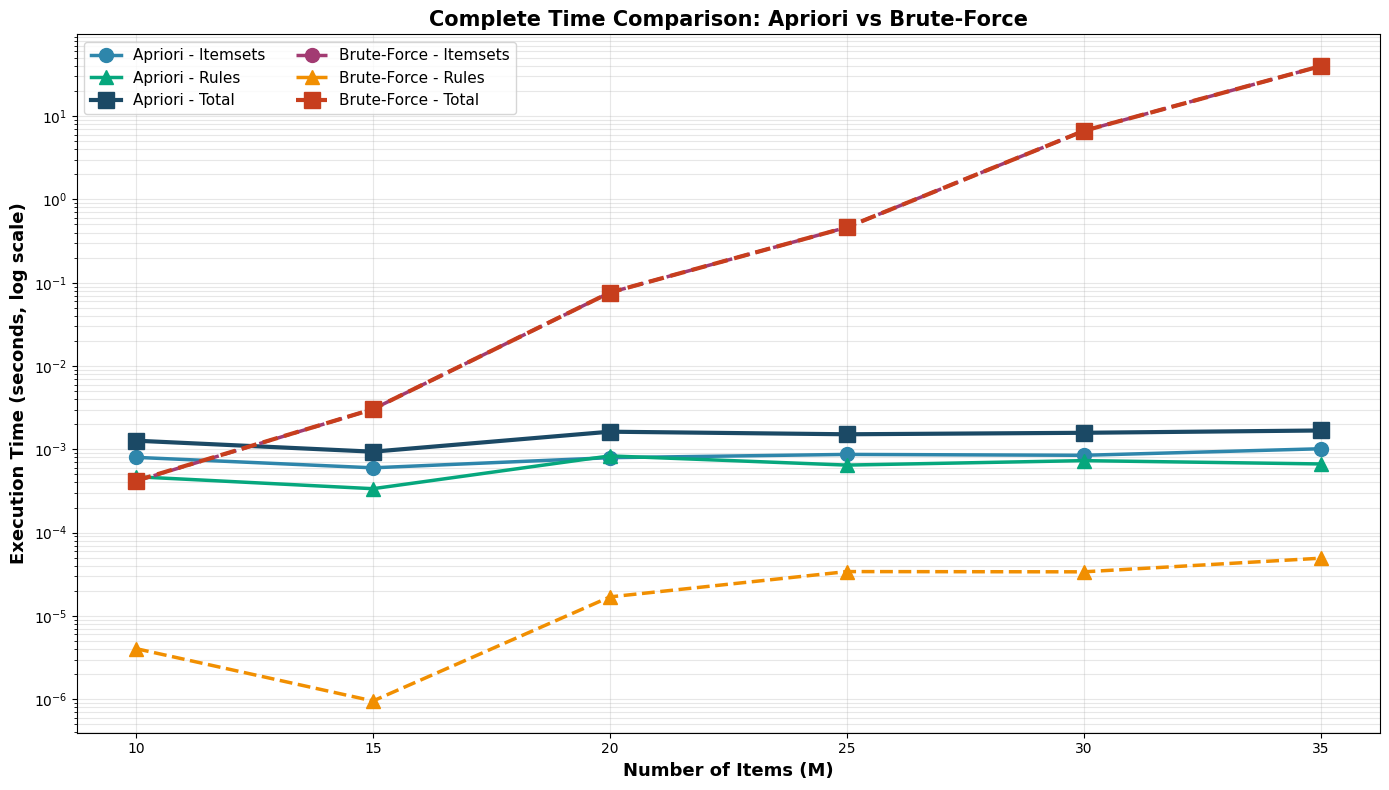
Constructed user-movie transaction baskets (filtered for ratings ≥ 4.0 and ≥ 25 users). Benchmarked the Apriori algorithm against an exhaustive brute-force itemset generator across varying basket sizes (M = 10 to 35), evaluating execution runtime, support, confidence, and lift.
Runtime Benchmark: Apriori vs Brute-Force Scaling Comparison (Log Scale)
from mlxtend.frequent_patterns import apriori, association_rules

# Mining frequent itemsets with minimum support threshold
frequent_itemsets = apriori(
    basket_df,
    min_support=0.05,
    use_colnames=True
)

# Generating high-confidence association rules
rules = association_rules(
    frequent_itemsets,
    metric="confidence",
    min_threshold=0.5
)

# Ranking rules by lift and confidence
strong_rules = rules[rules['lift'] > 1.2].sort_values(
    by='lift',
    ascending=False
)Assignment 3: K-Means Clustering & Centroid Visualizer
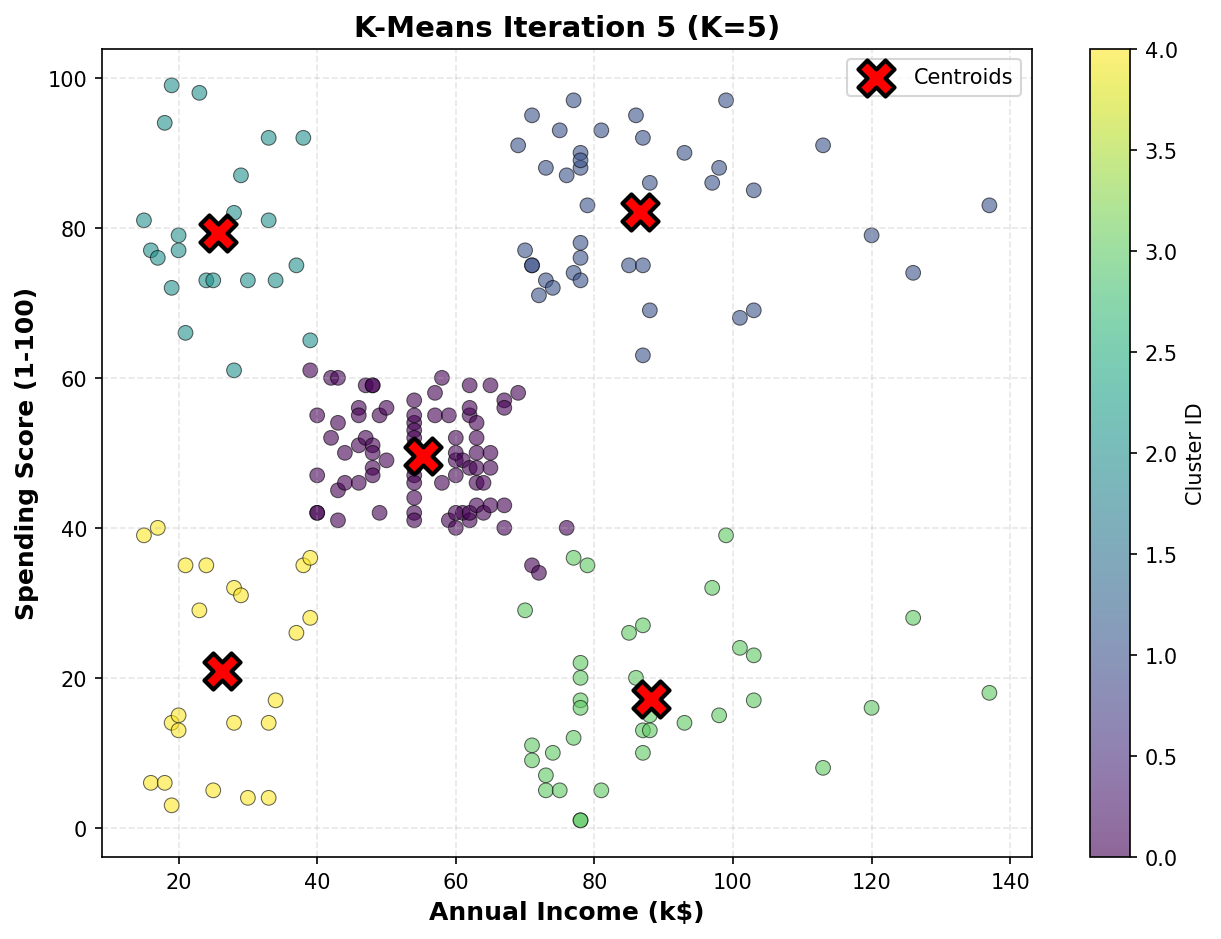
Unsupervised segmentation on customer spending and income attributes. Determined optimal cluster count (K=5) using WCSS Elbow method and Silhouette coefficient. Built a custom KMeansVisualizer tracking step-by-step centroid updates across iterations.
Customer Segmentation: K-Means Cluster Centroids & Iterative Convergence (K=5)
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

# WCSS Elbow calculation and Silhouette analysis
wcss, silhouette_scores = [], []
for k in range(2, 11):
    model = KMeans(n_clusters=k, init='k-means++', random_state=42)
    model.fit(X)
    wcss.append(model.inertia_)
    silhouette_scores.append(silhouette_score(X, model.labels_))

# Optimal K=5 selected based on the elbow curve and silhouette peak
optimal_kmeans = KMeans(n_clusters=5, init='k-means++', random_state=42)
optimal_kmeans.fit(X)